
AI 配音与口型
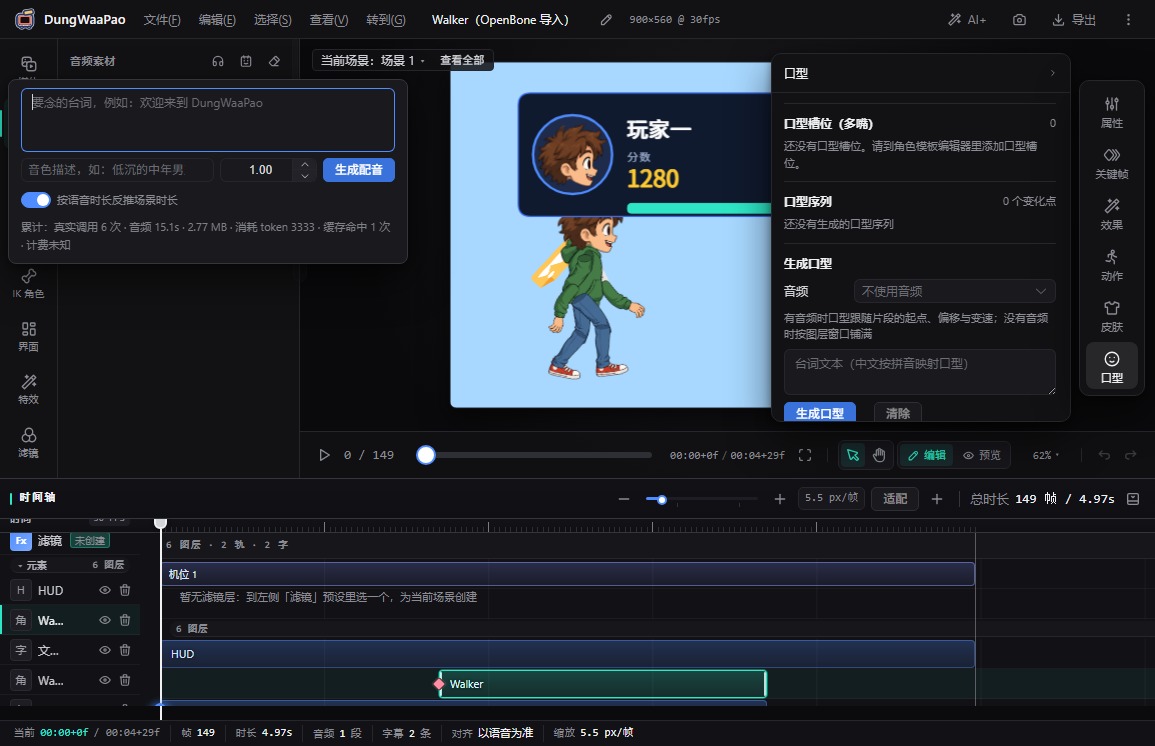
台词可以直接生成配音落到音轨,角色再按同一段音频生成口型关键帧。改稿时只改文本,不用重新对轨。
能做什么
- 台词生成配音:在顶栏「AI+」的「AI 配音 (TTS)」标签里输入台词,填音色描述、调速度。
- 自动落轨:生成后音频入库,并在当前场景的默认音轨生成片段,播放头跳到片段起点。
- 时长对齐:「按语音时长反推场景时长」默认开启,场景时长会跟着语音走。
- 用量可见:面板累计显示调用次数、音频时长、文件体积与 token 消耗。
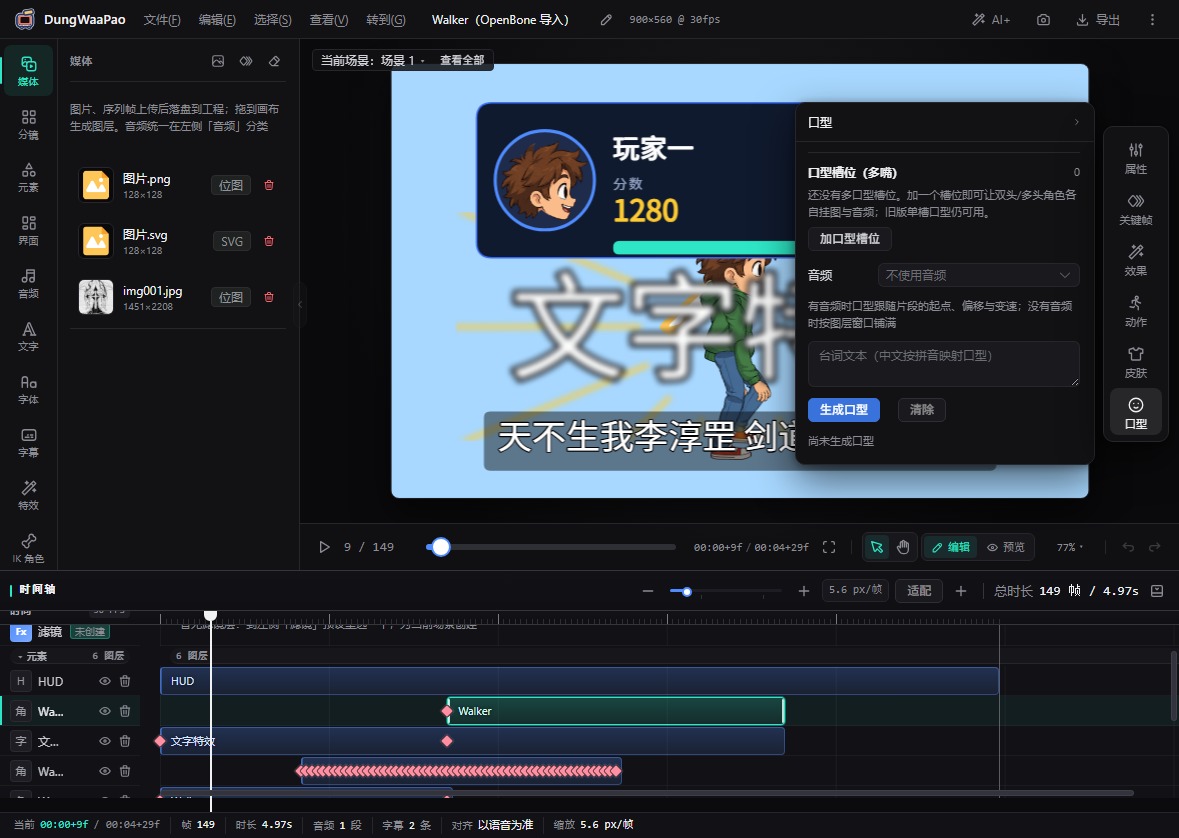
- 口型生成:选中角色图层,在「口型」面板选一段场景音频并填台词,按波形与音节生成口型关键帧。
- 口型图集:为 9 个口型逐个指定嘴部贴图,没配全时用程序化嘴型兜底。
怎么用
- 点顶栏「AI+」,切到「AI 配音 (TTS)」,输入台词并选音色。
- 点「生成配音」,音频会出现在当前场景的默认音轨上。
- 选中角色图层,dock 切到「口型」,在「音频」下拉里选刚生成的片段。
- 把台词填进文本框——没有文本无法按音节对齐,生成会被拒绝。
- 点「生成口型」;再在「嘴部与图集」里选嘴部槽位并配置口型贴图。
::: note 关于语音来源 配音请求由服务端代理,前端拿不到语音凭据。没有配置独立的 TTS 凭据时,会生成占位音频用于打通「生成 → 落轨 → 出片」整条链路。 :::
边界与提醒
- 口型跟随音频片段的起点、偏移与变速;不选音频时按图层窗口铺满。
- 没有选嘴部槽位时图集不生效,嘴型仍由程序化兜底。
- 生成配音会产生真实调用与配额消耗,面板里会如实累计。
声音有了,接着看 骨骼动画,让角色动起来。